Imagens digitais coloridas podem ser codificadas em uma série de formatos, chamados de espaços de cores. Dependendo da aplicação pode ser mais conveniente trabalhar com um espaço de cores em particular. Neste texto iremos explorar dois espaços de cores bastante usados em Processamento de Imagens: RGB e HSV/HSL. Também iremos comentar brevemente sobre outros espaços de cores existentes e suas características.
O espaço de cores RGB
No espaço RGB uma cor é representada por uma tripla \((r, g, b)\) que codifica a quantidade de vermelho (r), verde (g) e azul(b) presente na cor. Este é um espaço de cores conveniente para a criação de telas pois mapeia facilmente para o sistema visual humano, que contém células receptoras para estas três cores. A cor \((0, 0, 0)\) representa o preto, enquanto \((1, 1, 1)\) representa o branco. Imagens em RGB são comumente representadas em computadores usando 1 byte para cada cor. Isto resulta em imagens em que (255, 255, 255) representa a cor branca.
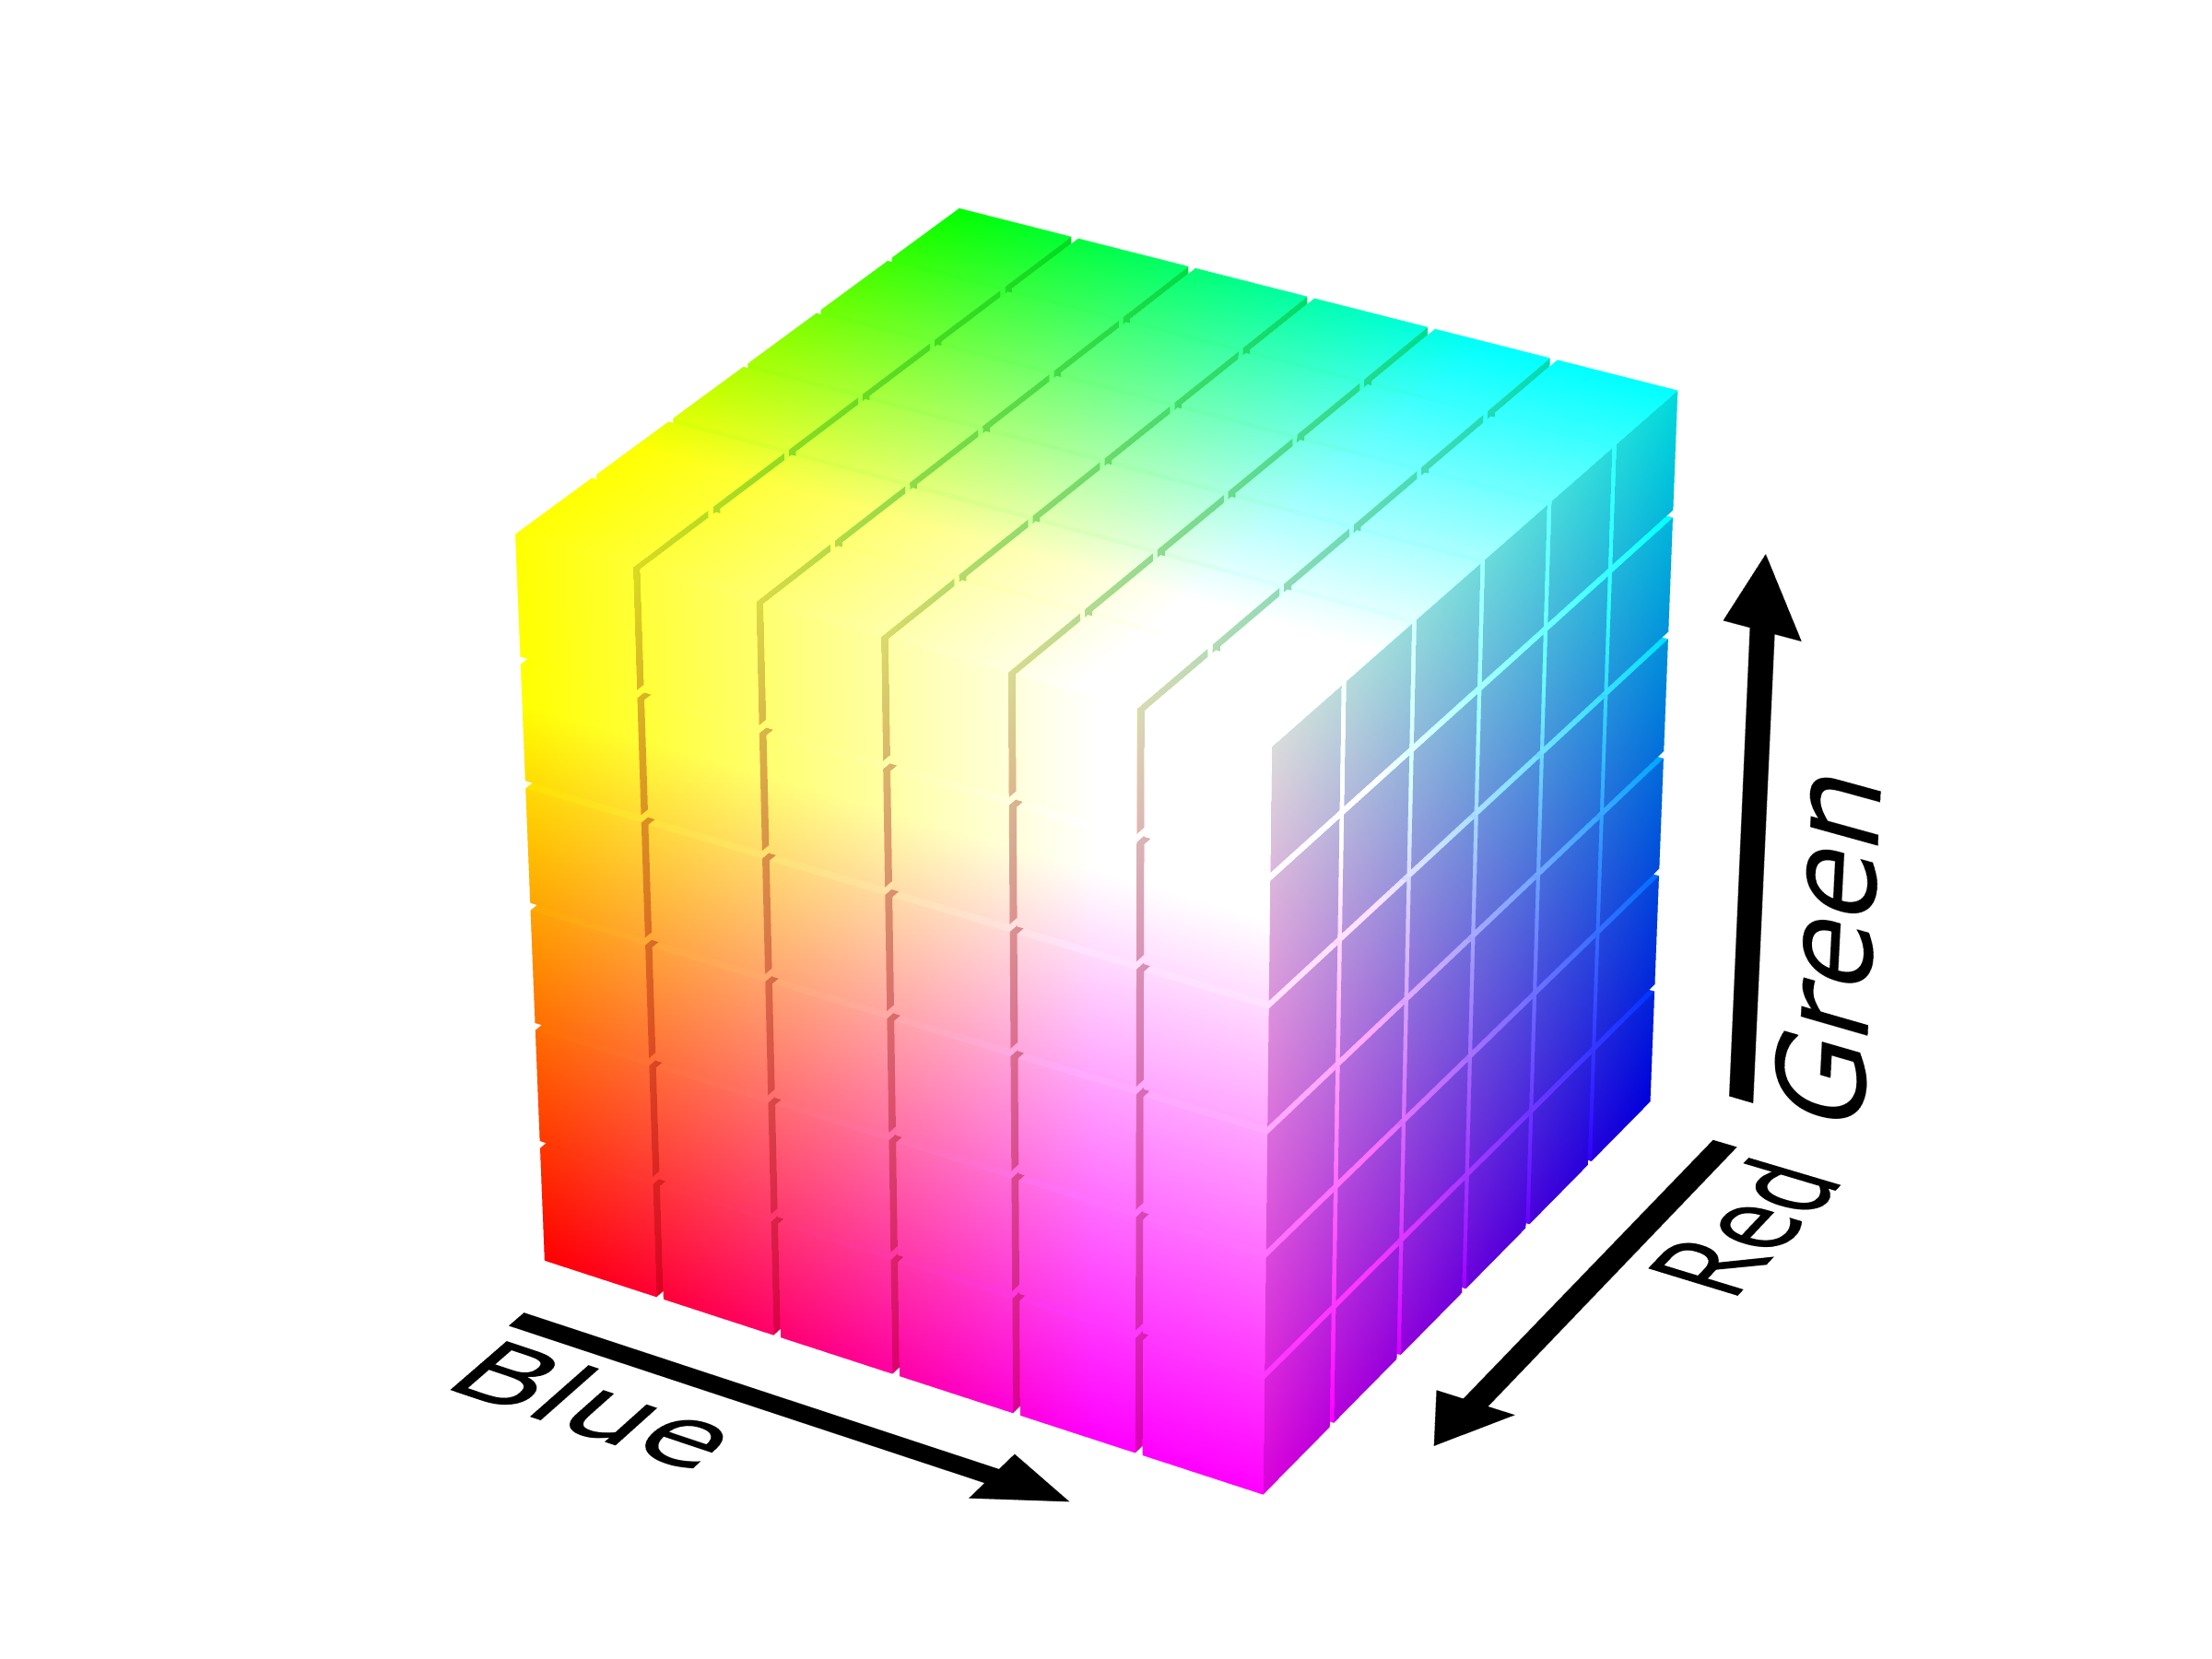
Espaço de cores RGB representado como um cubo. Por SharkD [fonte]
Podemos fazer segmentação de cores no espaço RGB de duas maneiras:
- Selecionando cores em um intervalo \([(r_1, b_1, g_1), (r_2, b_2, g_2)]\);
- Selecionando cores usando uma esfera ou elipse em torno de uma cor modelo.
Um dos problemas de fazer detecção de cores usando o espaço RGB é que a cor, assim como sua intensidade, fica espalhada nos três canais. No caso da opção 1, identificar os intervalos \([(r_1, b_1, g_1), (r_2, b_2, g_2)]\) pode ser uma tarefa trabalhosa. Os cantos do cubo formado pelo intervalo podem ser cores bem diferentes da desejada se optarmos por incluir todas variações da cor de interesse. Por outro lado, se evitarmos falsos positivos perdemos também muitas cores que são bastante similares à cor de interesse.
No caso da opção 2 precisamos definir um raio \(r\) (ou três raios \(r_r, r_b, r_g\) para a elipse) que contenha as cores desejadas. Apesar desta solução ser mais robusta, continua sendo necessário definir valores para estes parâmetros.
O espaço de cores HSV
Os espaços de cores HSV separam uma cor em três componentes: Hue (Matiz, de \(0^o\) a \(360^o\)), representando a cor do pixel; Saturação (\([0,1]\)), representando quanto a cor é pura; e Valor (\([0,1]\)), representando o brilho da cor. O canal H contém a cor vermelha em \(0^o\), passando por roxo, azul, ciano, verde, amarelo, laranja e vermelho novamente (próximo a \(360^o\)). Saturação pequena indica que a cor é próxima de um tom de cinza (incluindo preto e branco), enquanto Saturação \(1\) indica uma cor "forte". Um Valor pequeno representa cores escuras, enquanto um Valor (próximo de \(1\)) representa cores brilhantes.

Espaço de cores HSV representado como um cone. Por SharkD [fonte]
Diferente de imagens em RGB, que são comumente armazenadas em um uint8, cada implementação/biblioteca pode usar intervalos diferentes para cada um dos canais. Não se esqueça de consultar a documentação!
Uma das maiores desvantagens do espaço RGB é a dificuldade de modificar cores. Por exemplo, como podemos "escurescer" um cor? Como podemos escolher um laranja mais avermelhado do que outro? Ambas tarefas são facilmente realizadas no espaço HSV.
A segmentação de cores também é mais simples no espaço HSV. Ela pode ser feita com um simples intervalo no canal H. Para evitar a detecção de variantes muito escuras ou clares também podem ser adotados valores mínimos para Saturação e Valor.
Uma imagem RGB pode ser convertida para HSV usando a seguintes fórmulas. Primeiro definimos as constantes \(M = \max(R, G, B)\), \(m = \min(R, G, B)\) e \(C = M - m\).
A Matiz (Hue) é definida abaixo. Adotamos \(H = 0\) para tons de cinza.
\begin{equation} H' = \begin{cases} 0, & \textrm{if } C = 0 \\ \frac{G-B}{C} \mod 6, & \textrm{if } M = R \\ \frac{B-R}{C} + 2, & \textrm{if } M = G \\ \frac{R-G}{C} + 4, & \textrm{if } M = B \\ \end{cases} \end{equation} \begin{equation} H = 60^o \times H' \end{equation}O Valor é definido como
\begin{equation} V = M. \end{equation}A Saturação é definida como
\begin{equation} S = \begin{cases} 0 & \textrm{if } V = 0 \\ \frac{C}{V} & \textrm{otherwise} \end{cases} \end{equation}Uma variante do HSV é chamada de HSL e troca o Valor pela Luminância (quantidade de luz recebida). Apesar da troca de um canal, a detecção de cores não é afetada significativamente por esta mudança.
Imagens em níveis de cinza
Apesar de não ser exatamente um espaço de cores (já que só temos tons de cinza), mostramos nesta seção como converter imagens em RGB para níveis de cinza (abreviado para GL, do inglês gray-level).
Cada pixel em uma imagem em GL representa a quantidade de luz observada naquela ponto da imagem. Se nenhuma ou muito pouca luz é observada o pixel toma o valor \(0\) (preto). Se muita luz é observada o pixel toma o valor \(1\) (branco).
Uma maneira popular de converter RGB para GL é usando a fórmula abaixo. Ela é inspirada no sistema visual humano e pesa mais fortemente o verde que o vermelho e azul.
\begin{equation} L = 0.587G + 0.299R + 0.114B \end{equation}Outros espaços de cores (CMIK etc)
RGB é um sistema aditivo, ou seja, cores são criadas pela emissão de luz. O aumento de uma componente de uma cor implica em um aumento na emissão de luz nesta frequência. Em comparação, CMIK é um sistema subtrativo, ou seja, cores são criadas pela absorção da luz. Logo, CMIK é um formato muito presente na indústria de impressão, pois ele permite representar melhor cores em materiais impressos.

Mistura de cores por subtração - Por SharkD, Jacobolus e Dacium [fonte]
O espaço CMIK não é comumente usado em Processamento de Imagens e Visão Computacional. Ele está listado principalmente por curiosidade e completude. É importante saber que existem espaços de cores adequados para diversas aplicações.
Existem diversos outros espaços de cores (veja uma lista aqui) e cada um possui um caso de uso ideal. Apesar de RGB e HSV serem os mais usados em Processamento de Imagens, o conhecimento de outros espaços de cores pode ser um diferencial.
Bibliotecas para processamento de imagens em Python
Por fim, listo aqui algumas bibliotecas para Processamento de Imagens e Visão Computacional em Python.
- OpenCV - usado principalmente para aplicações de Visão Computacional, com ênfase no processamento de imagens em tempo real. Feito em C++, mas com excelentes wrappers para Python.
- Scikit-Image - Biblioteca parte do pacote Scipy para computação científica em Python. Integra muito bem com Numpy e tem diversos algoritmos de processamento de imagens já implementados. Mais completa que OpenCV em termos de quantidade de algoritmos implementados.
- Pillow - Uma biblioteca um pouco mais antiga de processamento de imagens usando Python. Pode ler uma grande quantidade de formatos de imagens.


